
 |
 |
 |
CPU種類:Apple M5 Maxチップ メモリ容量:36GB ストレージ容量:SSD:512GB 発売時期:Late 2026

※OSは出荷時期によって、変更されている場合があります。ご購入の際は購入店舗にて直接ご確認ください。
本ページでは掲載するECサイトやメーカー等から購入実績などに基づいて手数料を受領しています。
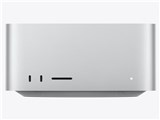
Mac Studio MHL64J/A [シルバー]Apple
最安価格(税込):¥415,602
(前週比:±0  )
発売日:2026年 9月22日
Mac Studio MHL64J/A [シルバー] のユーザーレビュー・評価




- 4 0%
- 3 0%
- 2 0%
- 1 0%
| 評価項目 | 投票平均 | カテゴリ平均 | 項目別ランキング |
|---|---|---|---|
デザイン
見た目のよさ、質感
|
5.00 | 4.75 | -位 |
| 処理速度
ストレスなく快適な処理が行えるか
|
5.00 | 4.53 | -位 |
| グラフィック性能
必要十分な描画性能を備えているか
|
5.00 | 4.38 | -位 |
| 拡張性
拡張スロットやポートの数は十分か
|
4.00 | 3.62 | -位 |
| 使いやすさ
機能性、キーボードやマウスの使いやすさ
|
5.00 | 4.46 | -位 |
| 静音性・発熱
動作音は静かか、発熱は抑えられているか
|
5.00 | 4.76 | -位 |
| 付属ソフト
付属ソフトの質と量は適切か
|
3.00 | 4.24 | -位 |
| コストパフォーマンス
価格に対する性能の高さ
|
4.00 | 4.31 | -位 |
- ※集計対象は通常レビューとキャンペーンレビューです。プロレビュー・モニターレビューは集計対象から除外しています
- ※「カテゴリ平均」より「投票平均」が高い項目を黄色背景にしています

よく投稿するカテゴリ
 2026年10月25日 13:27 [2038028-3]
| 満足度 | 5 |
|---|
| デザイン | 5 |
|---|---|
| 処理速度 | 5 |
| グラフィック性能 | 5 |
| 拡張性 | 4 |
| 使いやすさ | 5 |
| 静音性・発熱 | 5 |
| 付属ソフト | 3 |
| コストパフォーマンス | 4 |
【デザイン】
統一感がある。
ただしStudioを重ねるときは排熱のための隔離間隔を十分とる必要がある。下側の排熱を上側が吸気するとチンチンになるので注意。
【処理速度】
今回は、LLMサーバー専用として導入した。最速ではないが、価格と費用のバランスを見て選択。体感でも主だった雑誌などのベンチマークのレビューを見ても、思った以上にMaxが健闘している。
LM StudioでQwen3.6-35B-A3B-MLX-4bitをシンプルなプロンプトで動かしてみると、
Prediction Stats:
Stop Reason: eosFound
Tokens/Second: 130.41
Time to First Token: 0.185s
Prompt Tokens: 43
Predicted Tokens: 4970
Total Tokens: 5013
【グラフィック性能】
Cinebench 2026を回してみたら、GPU 95885 ptsだった。CPU (Multi Threads) 9779pts,(Single Thread)750pts.
MLXでLLMを回すときはほとんどGPUしか使わないので、GPU性能がほぼダイレクトにtok/sに直結する。いまのところ120BクラスのGLM5.3FlashQ2を主力に据え、250Kコンテキストで30tok/s、2並列では各クライアント15tok/sずつ長時間安定運用に入っている。
【拡張性】
TB5のポートはすぐ足りなくなり、ここはやはり不満が残る。特に複数ディスプレイでは外付けSSDと奪い合いで厳しい戦いになる。
【使いやすさ】
サードパーティ製ソフトも含めての評価になるが、LLMサーバーとしての運用のしやすさはMac一択だと思う。使ってると大概やらかすので、運用面ではリカバリ速度がものをいう。実際に使ってみると、迷わず回復できるバックアップソフトは限られる。仮想化ソフトと合わせて安心して試行錯誤ができる環境が整えられるという利点がある。
うちではAcronis+Parallelsを使っていて、エージェントに設定を壊されてもスナップショットで即ロールバックできるテスト環境が構築できる。また、ホスト側のmacOSを壊しても、丸ごとのリカバリーがすぐできる。こういった運用上のリスク管理しやすさがDGX Sparkだと真似できないところ。
【静音性・発熱】
単体の静音性や発熱はM4 Max Studioとそれほど変わらないと思う。
LLMサーバとして使っていると、CPUは数%程度だがGPUは100%に張り付くが、この状態でも触ってあったかいな程度でファン音も回ってるのかよくわからない。しかし、NAS・モニター・外付けSSD・スイッチの相乗効果で部屋の温度は確実に上がり、シロクマに詫びを入れたくなる。
【コストパフォーマンス】
メモリ量に支配された完全にローカルLLM向けの価格。クラウドがダウンした場合のBCPや、小さいリクエストをローカルで処理するなどの工夫で有効活用すれば見合った値段になる。
エージェントにアプリ作成をゆだねるとx5やx20プランでも天井打ちで5時間枠解放待ちが頻繁、下手すると週半ばで枯渇していて持続可能な使い方はできなかった。安価なOSS系APIでも月額3000円程度のプランでは即蒸発する。
そんな中で、ローカルLLMサーバに各社のエージェント環境を接続し、環境をほぼそのまま流用できるようになったので時間拘束から解放された感がものすごい。金の力でトークンをねじ伏せている諸兄には、ぜひともこの解放感とアイディア出し→即成果物の快感に浸り、「フリーダァム!!!」と叫んでほしい。
【総評】
クラウドLLMが使えないと詰むでは話にならないので、縮退運転用の環境を整備するために購入。米国の報告書でも槍玉に挙げられているように、今後もオープンウェイトモデルの性能向上やモデルの公開が維持できるのか、など地政学的な影響も購入を急いだ理由の一つではある。
今春からずっと品切れ状態だったけど、企業が本気になってLLMを試してみようと購入すればあっという間に在庫が枯渇しそうで怖かった。
購入前の検討では、ローカルLLMを使う場合は春頃の70B-100Bクラスのものであればおおよそ使える印象だった。モデルサイズとしてはこの辺りの物が使えれば十分で、でかいモデルよりは複数モデル並列化・投機的実行用の小モデルを併用する方が効果的だと思っている。
DGXやRTXなどのSpark系が上限128GBのメモリを搭載するので、今後出てくるモデルのターゲットも必然そのサイズになると予測し、とりまメモリ容量はそれにあわせて長いものに巻かれた。
Maxを選択する以上、速度面でdenseモデルは捨ててMoEモデル一択に割り切って使う。これなら、Ultraでなくても十分使えるtok/sで運用できる。
正直にいうと、ローカルLLM用マシンとしてはまだ過渡期で、すでにM6も出ており次モデルが完成形になるだろうと思う。次の戦場はSSD-Streamingの速度向上、ユークリッド距離→マハラノビス距離・符号選挙→量子演算化による精度向上を組み合わせ、代表値MoEを実用化して必要メモリ量を下げ、実用的な速度の600Bを載せてくるとみている。
次モデルはいつ出てくるかは分からないが、メモリが値下がりしても次モデルを値下げするとは考えにくい。おそらくメモリ増量・価格維持だと思うので、M7U Studioの吊るしが128GBだったら移行できる余力は残しておきたい。
参考になった1人(再レビュー後:1人)
このレビューは参考になりましたか?


この製品の最安価格を見る
 <21
のユーザーが価格変動や値下がり通知、クチコミ・レビュー通知、購入メモ等を利用中です
最適な製品選びをサポート!
[Mac デスクトップ]
Mac デスクトップ
(最近3年以内の発売・登録)






(Mac デスクトップ)
- コミュニティ規定の内容をご確認の上、ご利用ください
- 評価は投票された方の主観による目安であり、絶対的な評価を保証するものではありません
- 点数はリアルタイム更新です
- ユーザーレビューの使い方、よくある質問 FAQもご参照ください
価格.comマガジン
注目トピックス